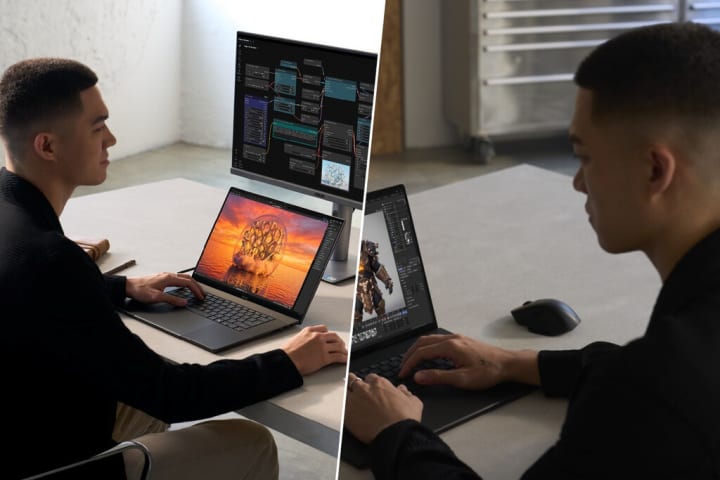
ASUS ProArt P16 (RTX Spark), anàlisi: Nvidia ha ficat una petita fàbrica de tokens en un portàtil
Bufen nous aires en la indústria dels PCs i els portàtils. Després de dècades de domini imperial de l'arquitectura x86, Nvidia vol donar-li la volta a la truita amb els seus nous xips ARM, els RTX Spark . Ve avisant des de fa temps de les seves intencions, i aquesta ambició a la fi ha cristal·litzat.
Ho ha fet amb els primers equips basats en aquests SoC, que desafien l'statu quo del segment i el fan a més amb una proposta d'allò més completa. Ho hem pogut comprovar de primera mà aquests dies, perquè hem tingut l'oportunitat de treure molt de suc al ASUS ProArt P16 , un dels primers equips basats en aquesta plataforma de Nvidia.
Tenim molt de què parlar. Comencem.
ARM com mai havíem vist a ARM en Windows
Nvidia portava anys mirant de reüll el mercat dels PCs i portàtils amb una ambició renovada. no li bastava amb subministrar les targetes gràfiques que durant anys han conquistat el mercat gaming: volia una mica més. Volia oferir el seu propi SoC per a iniciar una nova era de portàtils Windows basats en els seus xips amb arquitectura ARM.
No és el primer a intentar-ho —hola, Qualcomm—, però si el que per descomptat abasta aquesta tasca amb un objectiu clar: mentre que anteriors intents semblaven tractar de convèncer-nos de la validesa de l'arquitectura ARM per la seva eficiència i el seu rendiment per watt, aquí Nvidia no es camina amb chiquitas : aquests xips són relativament eficients, sí, però destaquen sobretot per la seva potència.
Fitxa tècnica del ASUS ProArt P16 (H7607)
ASUS ProArt P16 (H7607, RTX Spark)
Pantalla
FEU OLOR 16" UHD+ (3.840 x 2.400) / 3K (2.880 x 1.800)
16.10, 120 Hz, 700/500 nits (estàndard), 1.600/1.100 nits (pic)
Multitouch, HDR True Black 1400 / 1000, suport stylus
Processador
Nvidia RTX Spark N1X amb #CPU de 20 nuclis
Nvidia RTX Spark N1X amb #CPU de 18 nuclis
Gràfics
Nvidia Blackwell RTX amb 6.144 nuclis
Nvidia Blackwell RTX amb 5.120 nuclis
Memòria
24 / 32 / 48 / 64 / 128 #GB memòria unificada LPDDR5X
Fins a 300 #GB/#s d'amplada de banda
Emmagatzematge
512 #GB / 1 #TB / 2 #TB SSD NVMe PCIe 4.0
Ranura d'expansió
2 x #M.2 2280 PCIe 5.0x4
Ports
3 x #USB-C (#USB 4.0 Gen 3, 40 Gbps)
1 x #USB-A (#USB 3.2 Gen 2, 10 Gbps)
1x 3,5 mm
1 x HDMI 2.1
Lector #SD Express 7.0
Teclat i touchpad
Teclat retroiluminado (recorregut 1,7 mm)
Touchpad háptico
Webcam
Cambra Full #HD
ANAR amb suport Windows Hello
Connectivitat
Wi-Fi 7, Bluetooth 5.4
Bateria
99,9 WHrs
Adaptador de 140 W, cable #USB-C (240 W) inclosos
Dimensions i pes
354,1 x 243 x 12,9-15,9 mm
1,77 kg
Sistema operatiu
Windows 11 Home / Pro
Preu
Des de 3.499 euros
ProArt P16 (H7607)
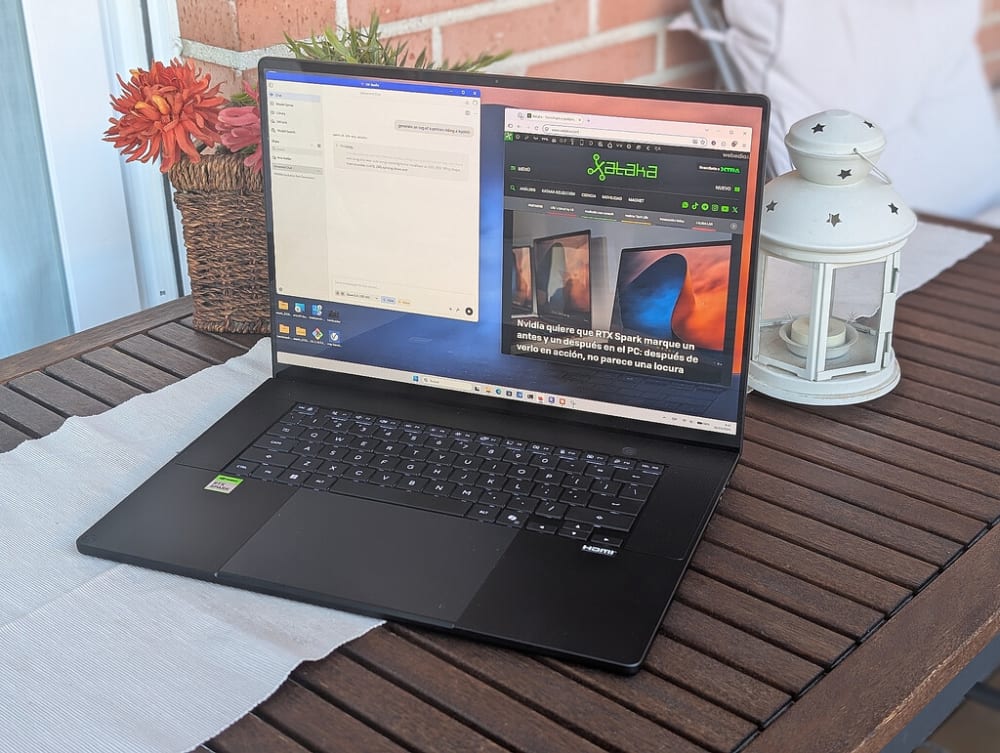
Un disseny elegant i, sobretot, contundent
El ASUS ProArt P16 ( H7607BA ) és un dels primers equips que ofereixen aquests xips, i ho fan a més acompanyats d'una configuració notable, sobretot per aquests fins a 128 #GB de "memòria unificada" LPDDR5X que són la clau per a poder carregar grans models de IA locals.
Nosaltres, això sí, hem provat l'equip en color negre que compta amb el RTX Spark en la seva versió amb la #CPU de 20 nuclis , GPU de 6.144 nuclis, 64 #GB i pantalla FEU OLOR 3K.
Estem davant un portàtil amb uns acabats cuidats, sobris i elegants. No hi ha aquí estridències i el que sorprèn és una primesa que després de les proves se'ns ha antullat fins a exagerada.
I és que aquests 15,9 mm de gruix en la part més "inflada" són tot un prodigi de la miniaturització, però com veurem més endavant, potser no hagués estat de més donar una mica més de marge a la refrigeració d'un equip que quan es posa a treballar de debò no va sobrat d'espai per a deixar escapar la calor generada per aquests components.
Sigui com sigui, tenir un equip amb pantalla de 16 polzades i aquestes dimensions és tot un luxe: el seu pes de 1,77 kg ho converteix en un portàtil dens i contundent . Un que no enganya i que mostra des del primer moment que està pensat per a usuaris ambiciosos.
La pantalla FEU OLOR de 16 polzades té acabada lluentor, i la seva qualitat és excel·lent: nosaltres comptem amb el panell 3K, i en aquesta configuració els colors i el contrast són envejables. La qualitat d'imatge i la resolució fan que treballar amb l'equip en l'apartat visual sigui una gaudida, però també és possible esprémer aquesta pantalla amb continguts de vídeo amb els quals el panell destaca de manera clara.
Estem a més davant un panell amb suport multitouch en el qual fins i tot podrem usar un stylus, però cura. la pantalla no s'abat del tot i no estem davant un convertible. Així i tot, aquest suport és més que benvingut i ASUS completa el cercle amb una taxa de refresc de 120 Hz i una webcam FHD amb suport Windows Hello.
El teclat és fantàstic: el tacte i recorregut de les tecles és excel·lent, i no vam tenir problemes a acostumar-nos ràpidament a la distribució ANSI dels EUA, encara que aquí hi ha algun sacrifici ja tradicional com el d'unes tecles de cursor que són la meitat de la resta de les tecles normals per a poder mantenir-les en aquesta fila inferior del teclat.
Mentrestant, el touchpad amb tecnologia hàptica segueix aquesta tendència que hem vist i abraçat en els últims temps en aquests components: és enorme, i ocupa pràcticament la meitat del que ocupa el teclat . El tacte i el suport de gestos és fantàstic i la citada resposta hàptica es comporta a la perfecció.
Els ports disponibles compleixen: tenim tres ports #USB-C (USB4) i fins a un port #USB-A, i a ells s'uneix el port HDMI 2.1, el port d'auriculars i fins a un lector de targetes #SD. Potser alguns troben a faltar un port Ethernet, però donat el gruix de l'equip integrar-lo era complicat.
La connectivitat sense fil està també molt ben coberta amb el suport Wi-Fi 7 i Bluetooth 5.4. Quant a la càrrega, amb l'equip s'inclou un (sorprenentment) petit adaptador de 140 W i un cable #USB-C que podrem usar en qualsevol dels ports d'aquest tipus que tenim en l'equip.
El xip promet, la "memòria unificada" promet més
No obstant això el protagonista absolut de l'equip és el SoC creat per Nvidia i MediaTek, el N1X que compta amb una #CPU de 18/20 nuclis i una GPU amb arquitectura Blackwell (la mateixa de les RTX 50) de 5.120/6.144 nuclis.
En les nostres proves, la #CPU del RTX Spark va obtenir 540 punts en single core i 6.855 punts en multicore en Cinebench 2026. Mentrestant, Geekbench 7 va mostrar 2.522 i 21.774 punts respectivament en aquestes configuracions. Per a fer-nos una idea, estem davant un SoC que clarament competeix amb el M4 Pro que per exemple obté 3.375 punts en single core i 24.890 punts en multi core en Geekbench 7.
Les xifres mostren que estem davant un processador més que decent però que no brilla de manera espectacular en tasques monohilo. El xip sí que guanya enters en multifil, on com veiem està prop d'aquest M4 Pro , i aquí es nota que de moment en SoCs ARM Apple continua marcant el seu poder.
De fet, el M4 Pro i el M4 Max es van presentar a l'octubre de 2024 ; el GB10 que és la base del N1X ho va fer a l'octubre de 2025. La bona notícia? Aquest és només el principi del camí per a Nvidia, i sens dubte les prestacions de les seves SoC ARM milloraran en pròximes generacions.
L'altra part integral d'aquesta aposta és la "memòria unificada" (el mateix terme que porten anys usant en Apple) que inclouen aquest equip i els seus "cosins" de la resta de fabricants: fins a 128 #GB de memòria que es comparteix entre la #CPU i la GPU.
És possible canviar l'assignació de memòria fàcilment des de l'aplicació Nvidia App: en l'apartat Sistema->Avançat veurem com podem arribar fins als 48 #GB assignats a la GPU com a màxim en aquest equip, la qual cosa deixa 16 #GB de memòria per al sistema operatiu i les aplicacions.
Jugar amb aquesta configuració dóna una mica més de marge per a carregar models de IA amb major finestra de context, i és una forma senzilla d'aprofitar al màxim aquest recurs. Cada canvi, això sí, necessitarà un reinici de la màquina perquè s'apliqui.
Usant la IA local com si no hi hagués demà
Encara que l'equip es comporta molt bé en tots els àmbits, hi ha una àrea en el qual brilla de manera especial. I aquest àrea és, per descomptat, l'execució de models locals de IA. Aquests 64 #GB de memòria unificada i la destacable GPU del SoC N1X donen aquí molt joc, i des del primer moment vam voler saber què podíem esperar d'aquest equip.
Per a això executem una bateria de proves recomanades per Nvidia i que ens van permetre demostrar que la velocitat de descodificació (generació de tokens) amb el popular model Qwen3.8-27B era més que decent en aquestes proves.
Prova
Qwen3.8-27B (UD-Q4_K_#M) amb DFlash 2
Speedbench, descodificació (tokens/#S)
27,22
AgentPerf Local, descodificació (tokens/#s)
35,96
AgentPerf Local, temps normalitzat (#s)
1.052,33
Context 16k: primer token (#s)
22,57
Context 16K: extrem a extrem (#s)
66,76
Context 32K: primer token (#s)
51,23
Context 32K: extrem a extrem (#s)
100,95
Context 64K: primer token (#s)
104,48
Context 64K: extrem a extrem (#s)
161,54
Cal assenyalar que el temps fins al primer token és més llarg com més ampli és el context: quan introduïm prompts de 64.000 tokens d'entrada, hem d'esperar uns 104 segons al fet que aquesta entrada es processi i computi, i la descodificació baixa a uns 18 tokens per segon: és el cost de processar aquests prompts en GPUs integrades, i és alguna cosa que notarem si usem l'equip amb documents llargs.
Realitzem altres proves sintètiques molt conegudes en aquest segment, com les pertentecientes a MLPerf Client. Allí el Data Analyst agéntico va trigar 62,6 #s a completar la tasca i el SWE Agent (programació) ho va fer en 96,1 #s, en aquest cas amb Qwen3.8-8B amb flama.CPP i CUDA.
També vam voler avaluar el comportament de LM Studio amb una petita variant de Qwen3.8: en concret aquesta versió amb descodificació especulativa TP i un petit afegit anomenat Q8 Attention que millora la qualitat de les respostes.
En el ASUS ProArt P16 vam posar com a exemple el prompt "genera un text de 1.000 paraules sobre l'evolució de Nvidia des del seu naixement". Vam obtenir un text molt decent que es va generar a 33,69 tokens per segon , una xifra espectacular per a un portàtil.
En les nostres proves amb un #PC amb un Core i5-13400 i una RTX 5090 amb Windows 11 i la mateixa app (LM Studio) i model, aquesta velocitat va ser de 83,85 tokens/#s. Tenint en compte que la RTX 5090 és una veritable bèstia, que el Soc RTX Spark generi respostes al 40% d'aquesta velocitat és sorprenent i molt bon senyal.
Aquesta capacitat per a usar models de IA locals també s'aplica a l'àmbit creatiu: aquí les proves amb ComfyUI i models com Flux2 van demostrar que és possible generar imatges (o vídeos amb altres models com Minimax H3) amb una qualitat fantàstica.
És cert que aquí els temps s'allarguen respecte a models en el núvol, però de nou aquesta capacitat de no haver de dependre d'aquests models, de generar-les "gratis" (sense comptar el preu de l'equip i la despesa en energia, clar) i de mantenir aquestes sessions privades és molt interessant.
Totes aquestes xifres ens parlen d'un rendiment prometedor, però on realment es nota la màgia de comptar amb una "fàbrica de tokens" és en treballar amb agents de IA de programació c neaomo OpenCode o, directament, fent una mica del que Nvidia va parlar molt en el seu RTX Spark Day: utilitzar agents de IA com OpenClaw, Hermes o Perplexity.
Mira mamà, el meu portàtil és una fàbrica de tokens
Nosaltres vam voler fer les nostres proves amb Hermes, un projecte que ha guanyat molts enters en els últims mesos per aquesta capacitat d'autoaprenentatge i actualització de les seves skills que fan que Hermes sigui "més intel·ligent" cada dia si actuem com a educadors diligents.
La instal·lació d'Hermes és bufar i fer ampolles en aquests equips RTX Spark, perquè un assistent de benvinguda precisament ens dóna a triar quin volem instal·lar en Windows 11 i el procés es realitza en tot just un parell de minuts: queden en el passat els processos una mica enutjosos que per exemple va plantejar OpenClaw.
Això que facilita que qualsevol usuari pugui experimentar amb un projecte que compleix la gran promesa de la IA: fer coses per tu . Hermes pot #convertir en un ajudant aplicat al qual li podrem demanar de tot i que serà més útil com més accés tingui a la nostra vida. Hem parlat ja amb freqüència de com Muse o Instinct són meravellosos fins que un pensa una mica en com exposa la seva privacitat.
Doncs bé, amb Hermes utilitzant models locals tenim el millor dels dos mons: una màquina que fa coses per nosaltres, però que no és tafanera: teòricament totes les nostres converses i dades es queden en l'equip i no surten d'aquí, alguna cosa que sens dubte és tranquil·litzador.
Aquí cal tenir en compte que aquesta privacitat depèn de la configuració de l'agent, les seves eines i connexions i la telemetria d'aquestes aplicacions: hi haurà potser metadades que surtin als servidors de certes eines (i si busquem en Google, continuarà havent-hi recol·lecció d'aquestes peticions de cerca, clar), però el compromís és molt més fitat que amb models en el núvol.
Però com dèiem, usar models locals en aquests equips ens dóna tokens infinits i sobretot, "gratis". És un "gratis" amb moltes cometes, perquè per a poder gaudir de tots aquests tokens la inversió inicial ha estat realment forta. Així i tot, si som usuaris intensius de models de IA, tenir a la nostra disposició aquesta capacitat de gaudir de models decents corrent en local és summament interessant.
Sobretot quan un veu com han evolucionat aquests models. És cert que no poden competir amb els millors models davantera, però atenció, perquè no estan tan lluny del que fa pocs mesos es considerava un model davantera . Qwen3.8-27B té en Artificial Analysis un "índex d'intel·ligència" de 34 punts, res mal tenint en compte que Claude Opus té 58... i que Claude Opus 4.7 Max arribava a 41.
La nostra experiència amb Hermes ha estat més que decent, amb velocitats mitjanes que rondaven els 20-25 tokens/#s en diferents converses, sempre amb Qwen3.8-27B. És una xifra notable sobretot tenint en compte que aquest és un model dens que carrega tots els seus paràmetres en memòria en lloc d'acudir a la filosofia Mixture-of-Experts d'altres models oberts.
En el nostre ús d'Hermes configurem per exemple un petit sistema de cerca i selecció de temes interessants que repassar cada matí: aquest butlletí matinal apareixia ja "curat" en el nostre correu en un format #HTML llegible i amb ell teníem un bon resum de les notícies més importants del dia res més aixecar-nos.
Hermes també és capaç de resoldre necessitats en matèria de projectes programari: en el nostre cas creem una pàgina web en la qual vam anar recopilant els resultats de les proves i els benchmarks realitzats en l'equip per a poder consultar-los fàcilment, per exemple.
De fet Hermes em va ajudar a automatitzar algunes d'aquestes proves gràcies a un "skill" en format Markdown (.md) que va proporcionar Nvidia. L'agent demana permís quan ho necessita (i podem donar-li permisos complets, encara que això pot ser arriscat i preferim no fer-ho), però és capaç de completar de manera autònoma bona part del treball sense més.
Autonomia, temperatures i soroll: bufits per onsevulla
Això li permet #comportar realment bé en molts escenaris, però imposa una càrrega important en les converses i l'equip el nota: els ventiladors comencen a bufar al màxim i la temperatura en la zona superior del teclat i també sota el portàtil s'incrementa de forma clarament sensible.
De fet, aquest és un dels inconvenients d'usar de manera intensiva la IA en aquest equip: el soroll és audible i molest, així que o tenim l'equip en una altra estada i el controlem remotament, o haurem de suportar aquest bufit constant si continuem posant-lo en destrets amb l'execució de models locals de IA.
Els enginyers de Nvidia ja ens van avisar d'això durant el RTX Spark Day, però aquests equips tenen un avantatge especial: no perden a penes rendiment quan els desconnectem del corrent : el lliurament de potència és pràcticament la mateixa tant si els tenim carregant constantment com si no, alguna cosa que no sol #complir en molts altres portàtils amb gràfiques dedicades, per exemple.
Aquest ASUS ProArt P16 compta amb una bateria de 99,9 Wh, una xifra fantàstica que dóna molt de marge per a treballar amb l'equip de forma estesa. Aquí, no obstant això, hi ha una gran diferència d'autonomia segons el que estiguem fent.
Així, en un ús estàndard de l'equip per a treball ofimàtic i navegació web aconseguim passar fàcilment de les 14 hores amb lluentor mitjana i manera equilibrada de rendiment. No obstant això, si desconnectem l'equip del corrent i comencem a córrer models de IA locals (o juguem), aquesta autonomia es redueix de forma molt accelerada, per la qual cosa en aquests casos convé tenir connectat el portàtil endollat al corrent.
Jugar en un RTX Spark és estupend, però DLSS té molt a dir
La GPU Blackwell del RTX Spark també ens ha permès posar a prova aquest ProArt P16 amb un altre dels àmbits en els quals promet destacar: els videojocs. Abans fins i tot d'entrar en ells, les proves sintètiques van deixar dues referències: 2.981 punts en 3DMark Steel Nomad i 11.474 punts en Solar Bay Extremi.
Totes dues proves serveixen per a situar el seu rendiment bàsic, encara que l'experiència gaming sempre depèn dels ajustos triats i, en aquest cas, de DLSS i generació de fotogrames que en aquest cas aporten molts enters.
En 'DOOM: The Dark Ages' vam obtenir 126,31 FPS de mitjana en l'escena 'Setge, part 1' a 1440p, amb DLSS en manera Equilibrada i generació de fotogrames 3X. La xifra demostra que la fluïdesa visual en la pantalla de 120 Hz de l'equip és estupenda. Cal aclarir que part d'aquests fotogrames són generats, de manera que no estem jugant a 126 FPS renderitzats ni es garanteix la mateixa resposta en els controls. La nostra experiència jugant al joc normal no obstant això va ser perfecta, fluida i sense corts o conflictes/artefactes gràfics.
En 'Shadow of the Tomb Raider' vam obtenir una segona referència amb el joc a 1440p, qualitat alta i DLSS equilibrat (aquí no hi ha suport de generació de fotogrames, per exemple). En el seu benchmark intern vam obtenir 95 FPS de mitjana, amb 72 mínims i 127 màxims. És un resultat que deixa marge per a aprofitar el panell 120 Hz del ASUS ProArt P16 en determinats moments, i demostra que la capacitat gràfica del xip no sols es pot dedicar a executar models de IA locals, sinó per descomptat també a aquest àmbit.
De fet la impressió que deixen aquestes proves és que es pot jugar realment bé en el ProArt P16 sempre que s'acceptin certs ajustos. DLSS resulta important si volem jugar a 1440p en qualitats altes , i la generació de fotogrames pot ajudar molt a la fluïdesa percebuda.
Però això és també el que defineix el límit d'aquesta proposta de Nvidia i els fabricants que han adoptat RTX Spark. Aquí per descomptat comptem amb la possibilitat de jugar sense problemes en resolucions 1440p fins i tot a títols exigents si fem algunes concessions, però els portàtils RTX Spark no poden #qualificar com a "portàtils gaming purs". Recordem: el xip és gairebé idèntic al GB10 de les DGX Spark de fa un any, i el seu focus continua sent l'execució de models locals de IA.
ASUS ProArt P16 amb RTX Spark, l'opinió de Xataka
El ASUS ProArt P16 demostra que hi ha lloc per a una classe diferent de portàtil Windows i que no tot té per què ser màquines amb xips d'Intel o #AMD. La #CPU de la plataforma RTX Spark compleix però no enlluerna, la pantalla i el disseny són excel·lents i estan a l'altura d'un equip premium i els jocs funcionen millor del que caldria esperar d'una GPU integrada, encara que DLSS té molt a veure en això.
La seva raó de ser real apareix quan volem executar models de IA locals: comptar amb CUDA i 64 #GB de memòria compartida permet treballar amb models i contextos que posen en dificultats a moltes gràfiques dedicades de portàtil, i és aquí on l'equip brilla amb llum pròpia.
Aquest avantatge, clar, té condicions. El ProArt P16 ens ofereix tots els avantatges d'un equip portàtil que podem portar-nos a qualsevol costat, però si juguem o usem IA a tota màquina (amb la manera rendiment), l'equip es torna sorollós i s'escalfa de manera notable. És un compromís clar per a un equip que no és en absolut barat i que no és recomanable per a qui només vulgui jugar, editar o fer consultes ocasionals a un chatbot: aquí costa justificar la seva validesa.
No obstant això si el que vols és experimentar amb models de IA locals de certa grandària en el teu portàtil en qualsevol moment i lloc, tenim a la fi una alternativa cridanera als MacBook Pro. Una que a més compta amb aquest suport natiu de CUDA que tan important és en l'àmbit de la IA.
Els preus de les versions actuals són les següents:
ASUS ProArt P16 (#CPU 18 cores, GPU 5.120 cores, 32 #GB, 1 #TB): 3.499,99 euros
ASUS ProArt P16 (#CPU 20 cores, GPU 6.144 cores, 48 #GB, 1 #TB): 3.999,99 euros
ASUS ProArt P16 (#CPU 20 cores, GPU 6.144 cores, 64 #GB, 1 #TB): 4.499,90 euros (el model que hem provat).
ASUS ProArt P16 (#CPU 20 cores, GPU 6.144 cores, 128 #GB, 2 #TB): 6.999,99 euros
8,8
A favor
El SoC N1X de Nvidia/MediaTek és solvent en la seva #CPU i especialment versàtil quant a la seva GPU, tant per a jocs com (sobretot) per a IA
La memòria unificada de 64 #GB permet carregar models de bona grandària i executar la inferència localment
La construcció és sòbria i impecable, i aquesta pantalla FEU OLOR 3K a 120 Hz és una veritable meravella
En contra
Si usem IA o juguem al màxim (manera rendiment), els ventiladors sonen molt i l'equip així i tot s'escalfa notablement
El rendiment de la #CPU no és espectacular, i en jocs la GPU rendeix especialment gràcies al suport DLSS
El preu és elevat, i la crisi de les memòries no ajuda si volem accedir a les configuracions de 64 o 128 #GB de #RAM
ProArt P16 (H7607)
Aquest dispositiu ha estat cedit per a prova per part de ASUS. Pots consultar com fem les reviews en Xataka i la nostra política de relacions amb empreses .
- La notícia ASUS ProArt P16 (RTX Spark), anàlisi: Nvidia ha ficat una petita fàbrica de tokens en un portàtil va ser publicada originalment en Xataka per Javier Pastor .
Text traduït automàticament al català (original en castellà).